Más allá del prompt engineering: cómo rediseñar un sistema de IA mejoró el rendimiento, la consistencia y la eficiencia de costos
Marco Ornelas||5 min de lectura
Las aplicaciones impulsadas por IA suelen tener un desempeño impresionante durante el desarrollo inicial. El verdadero desafío comienza cuando esos sistemas pasan a entornos de producción, donde la velocidad, la confiabilidad, la consistencia y los costos operativos se vuelven críticos.
En Blue Trail Software, enfrentamos recientemente este desafío mientras trabajábamos en una plataforma de reclutamiento impulsada por IA, diseñada para evaluar la compatibilidad entre candidatos y vacantes. Al principio, la plataforma ofrecía resultados prometedores, pero a medida que aumentó su uso, las inconsistencias y las limitaciones de rendimiento empezaron a afectar tanto la experiencia del usuario como la eficiencia operativa.
El problema no fue una falla total del sistema. Fue un deterioro gradual causado por la variabilidad, la latencia y los costos crecientes.
Este proyecto se convirtió en una lección sobre un principio cada vez más importante para los sistemas de IA modernos: el prompt engineering, es decir, el diseño de instrucciones para el modelo, no es suficiente por sí solo. Un rendimiento sostenible de la IA requiere arquitectura de software, orquestación y diseño determinista.
Los límites del prompt engineering monolítico
Nuestra plataforma usaba modelos de lenguaje de gran tamaño (LLM) para evaluar los perfiles de los candidatos frente a las descripciones de las vacantes y generar puntuaciones de compatibilidad.
Inicialmente, la implementación dependía en gran medida de un prompt extenso y cargado de instrucciones, diseñado para gestionar todo el proceso de evaluación.
Este enfoque generó varios problemas críticos.
Puntuaciones inconsistentes de la IA y variabilidad en los resultados
El problema más significativo era la inconsistencia.
La misma combinación de candidato y vacante podía producir resultados drásticamente distintos:
Primera evaluación: 60
Segunda evaluación: 10
Tercera evaluación: 95
Ningún dato de fondo cambió entre una evaluación y otra.
El sistema producía resultados impredecibles, lo que afectaba gravemente la confianza y la usabilidad.
En los flujos de trabajo de reclutamiento, este nivel de variabilidad genera preocupaciones importantes:
Menor confianza en las recomendaciones
Una mala experiencia de usuario
Dificultad para explicar los resultados
Mayor riesgo operativo
La consistencia es esencial para los sistemas de IA en producción.
Latencia y cuellos de botella de rendimiento
La arquitectura original obligaba al modelo a procesar:
Cientos de instrucciones
Archivos de perfil completos
Grandes conjuntos de datos de contexto
Lógica de puntuación compleja
Esto generaba retrasos significativos. Tiempo promedio de evaluación: 18 segundos por solicitud
Para los usuarios reales, esto generaba fricción y afectaba negativamente la capacidad de respuesta de la plataforma.
Alto consumo de tokens y costos operativos
Los prompts extensos y las respuestas de texto sin restricciones generaban un uso innecesario de tokens.
El resultado:
Mayores gastos de API
Un escalamiento ineficiente
Menor rentabilidad
A medida que los sistemas de IA crecen, la eficiencia en el uso de tokens se vuelve tanto una preocupación de negocio como técnica.
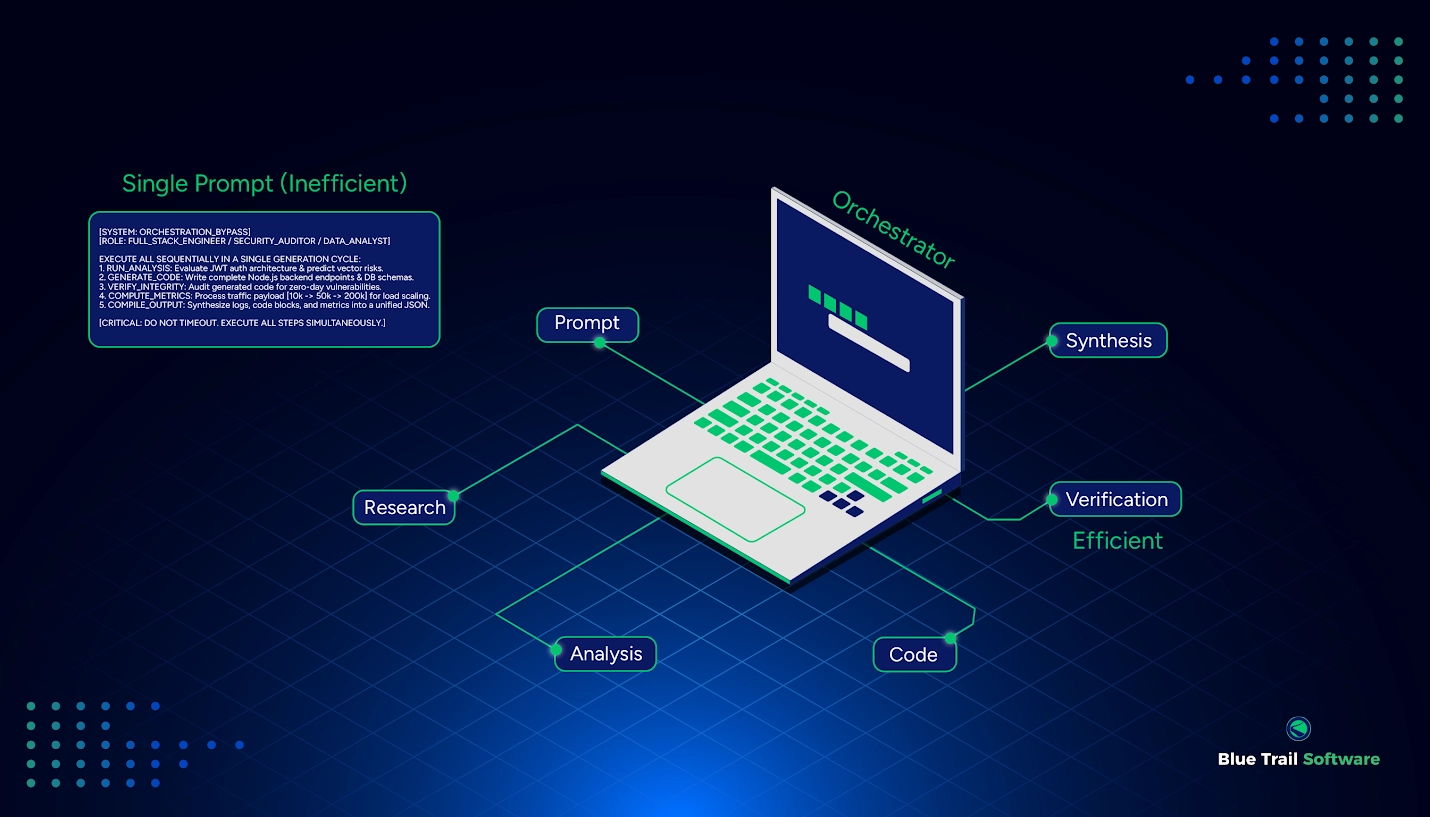
Rediseñar la arquitectura: del prompt a la orquestación de IA
En lugar de seguir optimizando un único prompt enorme, rediseñamos por completo la arquitectura del sistema.
El nuevo enfoque introdujo un modelo de orquestación con subagentes.
En lugar de pedirle a un solo modelo de IA que hiciera todo, distribuimos las responsabilidades entre componentes especializados.
Paso 1: incorporar un agente orquestador
Se creó una capa central de orquestación para gestionar el proceso de evaluación.
El orquestador:
Recibe la información del candidato y de la vacante
Recupera información de contexto a través de ChromaDB
Extrae las categorías clave de evaluación
Dirige la información a componentes especializados
Las categorías clave incluían:
Experiencia laboral
Habilidades técnicas
Formación académica
Afinidad con la industria
Competencias requeridas
Esto transformó una sola tarea de IA en evaluaciones más pequeñas y enfocadas.
Procesamiento de IA en paralelo para un mejor rendimiento
Cada categoría se enviaba simultáneamente a subagentes especializados.
En lugar del procesamiento secuencial:
Proceso anterior
Candidato → Prompt único → Evaluación
Proceso nuevo
Candidato → Orquestador → Varios agentes especializados → Resultados agregados
La ejecución en paralelo redujo significativamente el tiempo de procesamiento.
Resultados:
Latencia anterior: 18 segundos
Nueva latencia: 8 segundos
Esto representó una reducción de más del 50% en el tiempo de espera.
Sacar la lógica de negocio del LLM
Otra mejora importante consistió en separar el razonamiento de la IA de la lógica determinista de la aplicación.
En lugar de permitir que el LLM hiciera cálculos y devolviera respuestas abiertas:
La salida en JSON se volvió obligatoria
Las operaciones matemáticas pasaron a la API de la aplicación
Los cálculos de puntuación se volvieron deterministas
Esto generó varias ventajas:
Menos alucinaciones
El LLM dejó de generar cálculos inconsistentes.
Menor consumo de tokens
Las salidas estructuradas requerían menos tokens.
Mayor transparencia
Ahora los administradores podían ver:
Las puntuaciones individuales por categoría
Los criterios de evaluación detallados
La lógica final de ponderación
El sistema pasó a ser explicable en lugar de opaco.
Mejorar la consistencia de la IA con el preprocesamiento de datos
Durante las pruebas iterativas con herramientas como Claude Code, descubrimos algo importante: el problema no eran principalmente reglas defectuosas. El problema era una comprensión incompleta del contexto.
Cuando la información no era clara, el modelo improvisaba. Esa improvisación causaba una gran variabilidad en las puntuaciones.
Preprocesamiento de NLP con Python
Antes de que los datos llegaran al LLM, incorporamos técnicas tradicionales de procesamiento de lenguaje natural (NLP).
La capa de preprocesamiento aplicaba:
Lematización
Stemming
Normalización de habilidades
Ejemplos:
"Engineer"
"Engineering"
"Software Engineer"
Estos términos quedaban alineados semánticamente antes de la evaluación.
Entre los beneficios estuvieron:
Una mejor coincidencia de habilidades
Menos ambigüedad
Puntuaciones más consistentes
El NLP tradicional fortaleció significativamente el rendimiento de la IA.
Incorporar estructuras de decisión deterministas
Las estructuras de los prompts se rediseñaron con una lógica más explícita.
Los nuevos patrones incluían:
Reglas numeradas
Tablas de decisión
Condiciones de parada
Rutas de evaluación tipo if-else
Ejemplo: si falta un requisito obligatorio: devolver el resultado → detener la evaluación
Esto redujo la interpretación innecesaria del modelo y aumentó la previsibilidad.
Priorizar las habilidades y los requisitos críticos
No todos los requisitos de una vacante deberían pesar lo mismo en la evaluación de un candidato.
Incorporamos palabras clave críticas ponderadas para asegurar que las calificaciones esenciales tuvieran más influencia.
Ejemplos: requisitos críticos:
Lenguajes de programación requeridos
Certificaciones
Años de experiencia
Experiencia obligatoria en el dominio
Esto produjo un comportamiento de clasificación más realista y mejoró la calidad de las recomendaciones.
Reducir los costos de IA con caché en base de datos
Una de las optimizaciones de mayor impacto fue incorporar una capa de caché.
Cada par candidato-vacante generaba un hash único.
El sistema verifica: ¿esta evaluación ya se realizó?
Si los datos de fondo no cambian:
No se ejecuta ninguna solicitud al LLM
Los resultados en caché se devuelven al instante
En la práctica, las evaluaciones recurrentes pasaron a tener: costo de $0
Entre los beneficios estuvieron:
Menores gastos de API
Tiempos de respuesta más rápidos
Menor carga de infraestructura
Resultados: mejoras en rendimiento, estabilidad y costos
El rediseño de la arquitectura generó mejoras medibles en múltiples dimensiones.
Consumo de tokens
Antes: 5,000 tokens
Ahora: 3,500 tokens
Mejora:
reducción del 25%
Estabilidad de los resultados de la IA
Varianza promedio anterior de la puntuación: 37 puntos
Varianza promedio actual de la puntuación: 5 puntos
Mejora:
aproximadamente 86% más de consistencia
Reducción de costos de API
Mejoras combinadas a partir de:
La optimización de tokens
Las respuestas estructuradas
La caché en base de datos
Resultado: reducción del 30% en los costos totales de API
Lecciones aprendidas: el prompt engineering por sí solo no es suficiente
Una de las lecciones más importantes de este proyecto es que el prompt engineering no es un destino final.
Los sistemas de IA en producción requieren un enfoque de ingeniería más amplio que incluya:
Orquestación
Lógica determinista
Preprocesamiento de NLP
Salidas estructuradas
Estrategias de caché
Optimización continua
Los sistemas de IA más exitosos no son necesariamente los que tienen los prompts más sofisticados. Son los sistemas respaldados por una arquitectura de software sólida.
Reflexiones finales
Los sistemas de IA requieren cada vez más los mismos principios que cualquier plataforma de software madura:
Escalabilidad
Confiabilidad
Previsibilidad
Observabilidad
Eficiencia de costos
Con este rediseño logramos:
25% menos uso de tokens
30% menos costos operativos
Evaluaciones más de 50% más rápidas
Una consistencia drásticamente mejorada
Pero el resultado más valioso fue la confianza.
Los usuarios ya no dependen de la aleatoriedad de un prompt. Dependen de un sistema confiable diseñado para producción.
El futuro de las aplicaciones de IA quizá no se defina solo por mejores prompts. Cada vez más, se definirá por una mejor ingeniería.
Blue Trail Software Holding Inc.
Dirección:
182 Howard Street, Suite 226 San Francisco, CA 94105, USA